定位:面向 AI 的开源检索基础设施
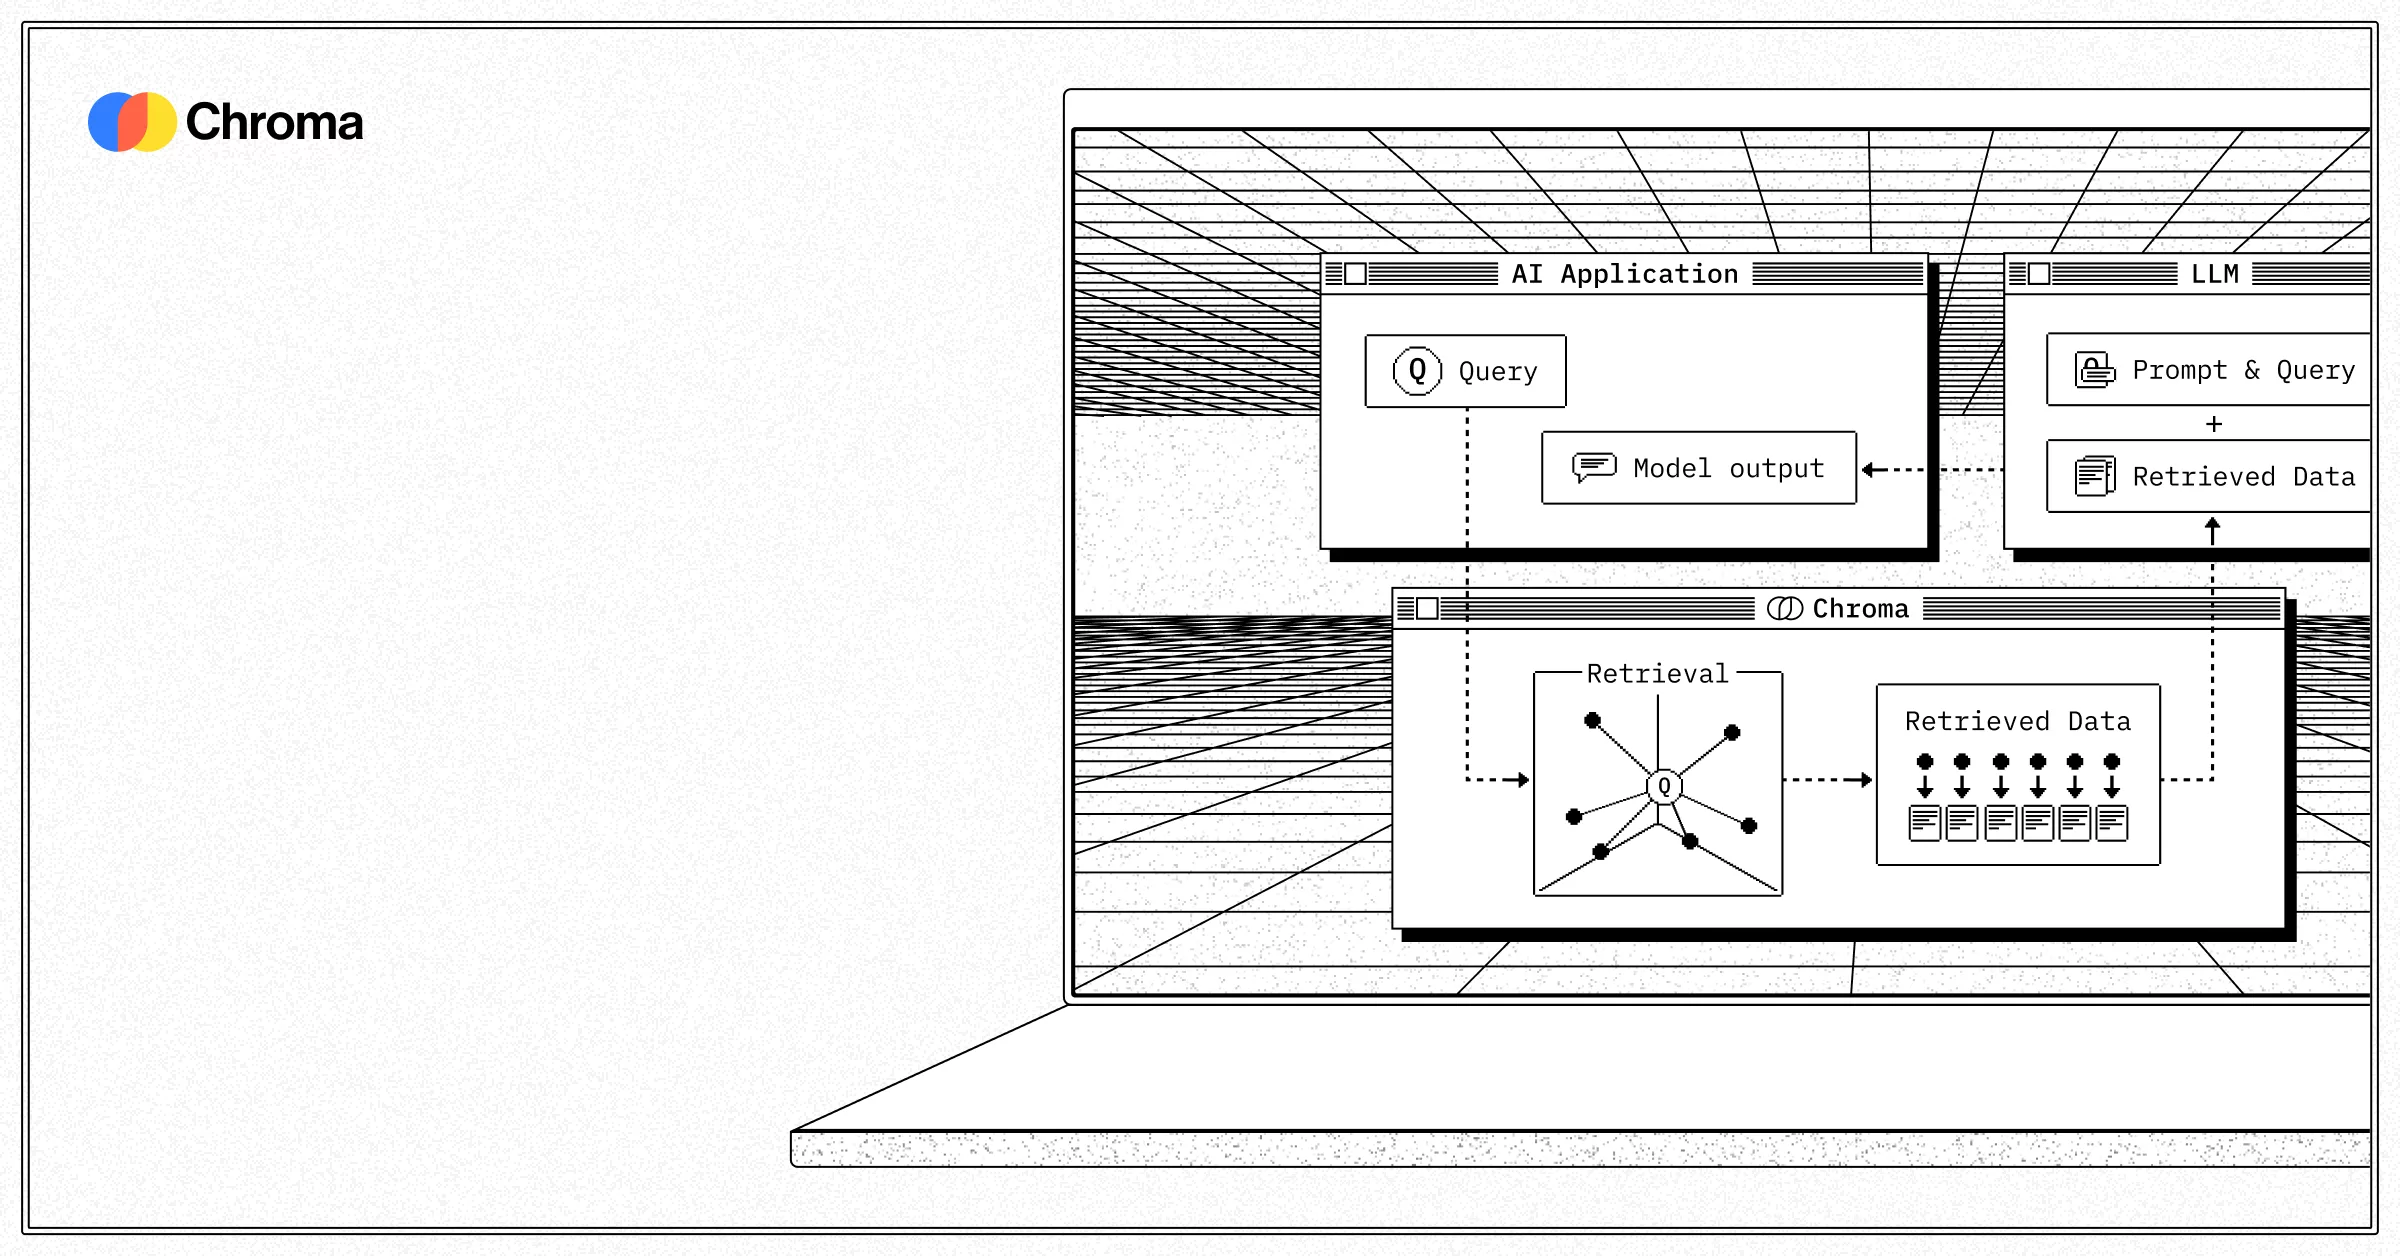
官方文档的第一句是「Chroma 是面向 AI 的开源数据基础设施,自带开始所需的一切,并且运行在你的机器上」,官网首页把它进一步描述为「支撑向量、全文、正则与元数据检索的快速、无服务器、可扩展基础设施」。它采用 Apache-2.0 许可,官网给出的规模口径是 GitHub 星标 2.7 万、月下载量超过 1500 万次。核验时仓库约有 2.93 万 star。对想快速验证检索方案的团队,这种「装完就能用、不用先搭集群」的起点是它最常被选中的原因。
向量与检索基础设施
Chroma官方定义是「面向 AI 的开源数据基础设施」,装好即可使用、也能跑在自己的机器上;同一套接口覆盖向量、全文、正则、稀疏与元数据检索,云端版本构建在对象存储之上并按用量计费。
深度介绍
官方文档的第一句是「Chroma 是面向 AI 的开源数据基础设施,自带开始所需的一切,并且运行在你的机器上」,官网首页把它进一步描述为「支撑向量、全文、正则与元数据检索的快速、无服务器、可扩展基础设施」。它采用 Apache-2.0 许可,官网给出的规模口径是 GitHub 星标 2.7 万、月下载量超过 1500 万次。核验时仓库约有 2.93 万 star。对想快速验证检索方案的团队,这种「装完就能用、不用先搭集群」的起点是它最常被选中的原因。
官网把能力列成一排可组合的检索方式:向量检索负责语义相似,稀疏向量检索支持 BM25 与 SPLADE,全文检索支持 Trigram 与正则表达式,元数据检索负责过滤与分面。官网的示例代码用 `Search()` 与 `rank()` 把不同检索方式拼成一次查询,最终返回文档与分数。对工程实践的意义在于:需要精确匹配的编号、需要模糊匹配的文本、需要按属性收窄的条件,可以在同一次调用里完成,不必再引入第二个检索引擎并处理两边结果的一致性。
官网强调它的索引是为对象存储构建并优化的:查询层用内存缓存热数据、SSD 缓存温数据,存储层把全部向量、元数据与索引放在 S3 或 GCS 上,由系统按查询模式自动分层。官方给出的成本对比很直接:向量体积大(1 GB 文本约对应 15 GB 向量),内存约每 GB 每月 5 美元,而对象存储约每 GB 每月 0.02 美元——这正是「最高便宜 10 倍」这一说法的来源。代价是冷查询要走对象存储,延迟显著高于热查询,选型时需要按查询热度分布来判断。
官网公开了一组可对照的数字:在 384 维、10 万向量的条件下,热查询的 p50 为 20 毫秒、p90 为 27 毫秒、p99 为 57 毫秒;冷查询分别为 650 毫秒、1.2 秒与 1.5 秒。规格方面列出单集合写入吞吐 30 MB/s(2000+ QPS)、并发读 10 路(200+ QPS)、每库最多 100 万个集合、单集合最多 500 万条记录、召回率 90%–100%,并说明专属集群可按需调整。这些数字来自官方基准,迁移到自己的数据与查询分布时应重新实测。
官网把「Forking」列为一项独立能力,用于数据集版本管理、A/B 测试与逐步放量:同一个集合可以分叉出不同版本,在真实流量下比较检索效果再决定采用哪一个。配合文档中的条件事务(conditional transactions),可以在不改动应用逻辑的前提下控制写入的原子性。对需要持续调优检索质量的团队,这套机制把「换嵌入模型、换切块策略」从一次性上线变成了可回滚的实验流程,这是许多同类产品尚未提供的能力。
Chroma Sync 是官方推出的无服务器数据摄取服务,直接连接 S3 存储桶、代码仓库与网站,自动完成解析、切块与嵌入,让新数据在几分钟内可被检索,起价为每 GiB 处理量 0.04 美元。官方说明它用队列系统统一处理少量文件到数百万文档,具备重试、限流感知与自动错误恢复,并可在仪表盘或通过接口监控每次调用。对已有大量文档散落在对象存储与内部的团队,这条链路省掉的正是「写一套同步脚本并长期维护」的负担。
官网产品线里还有 Context-1,官方称它是自研的开放权重模型,使用监督微调与强化学习训练,在检索任务上可与前沿模型竞争,同时「快 10 倍、便宜 25 倍」,目前通过接口等候名单开放。官方的论证角度是:智能体大量时间花在收集信息上,模型推理速度才是瓶颈,而检索调用本身只占很小一部分耗时,因此把检索能力做进模型比单纯堆检索基础设施更有效。该产品仍在早期,能力与可用性请以官方当期说明为准。
开源部分以 Apache-2.0 许可发布,自托管无授权费用;官方声明云服务通过 SOC 2 Type II。企业版在此之上提供 BYOC(数据面部署在自己 VPC 内、控制面由官方托管)、多云与多区域复制、时间点恢复,SLAs 与单租户集群也在企业档内。云端方案分三档:Starter 为 0 美元加用量、含免费额度,Team 为每月 250 美元加用量并提供 100 个数据库与支持,Enterprise 为定制报价。需要处理敏感数据的团队应把 BYOC 与数据驻留要求放在评估清单最前面。
产品特点
官网列出的检索方式包括向量语义检索、稀疏向量检索(BM25、SPLADE)、全文检索(Trigram 与正则)与元数据过滤和分面,并可在一次查询中组合,避免为精确匹配另引入一套检索引擎。
全部向量、元数据与索引存放于 S3 或 GCS,查询层用内存与 SSD 做热温缓存;官方用内存与对象存储的价格差解释「最高便宜 10 倍」,代价是冷查询延迟明显高于热查询。
Forking 能力支持数据集版本管理、A/B 测试与逐步放量,配合条件事务与元数据过滤,可以把换模型、换切块策略变成可回滚的实验,而不是一次性上线。
开源版可自托管且无授权费,云服务按用量计费并声明通过 SOC 2 Type II;Sync 可直接连接 S3、代码仓库与网站完成解析、切块与嵌入,企业档另提供 BYOC 与多区域复制。
最近动态
官网当前把产品分为 Sync、Database 与 Agent 三条线:Sync 负责从 S3、代码仓库与网站摄取数据,Database 是检索本体,Agent 线围绕自研检索模型 Context-1 展开,后者标注为开放权重、通过等候名单开放。产品页与定价仍在调整,以官方当期说明为准。
价格页列出 Starter(0 美元每月加用量、含免费额度)、Team(每月 250 美元加用量、100 个数据库、含支持)与 Enterprise(定制);用量单价为写入每 GiB 2.50 美元、存储每 GiB 每月 0.33 美元、查询每 TiB 0.0075 美元、回传流量每 GiB 0.09 美元,Sync 另按每 GiB 处理量 0.04 美元起计。
PyPI 上的 chromadb 与仓库发布记录显示最新版本为 1.5.9,发布于 2026 年 5 月 5 日;主仓库在 2026 年 9 月 21 日仍有提交,说明开发仍在继续,但正式发版节奏与提交节奏并不一致,生产环境应以发布版本为准并关注变更日志。
官方文档按概览、集合管理、增删改查、条件事务、配置、查询与过滤、全文检索、嵌入函数、多模态嵌入、命令行与服务端运行、数据管理、云服务与迁移组织,客户端提供 Python、TypeScript 与 Rust 三种,并给出可直接交给编码 Agent 执行的安装提示词。
Chroma 是面向 AI 的开源检索基础设施。官方文档的表述是「面向 AI 的开源数据基础设施,自带开始所需的一切,并且运行在你的机器上」,官网则把它描述为支撑向量、全文、正则与元数据检索的快速、无服务器、可扩展基础设施;项目以 Apache-2.0 许可发布,官网给出的口径是 GitHub 星标 2.7 万、月下载量超过 1500 万次,核验时仓库约有 2.93 万 star。 检索能力的特点是「一套接口多种检索」:向量检索负责语义相似,稀疏向量检索支持 BM25 与 SPLADE,全文检索支持 Trigram 与正则表达式,元数据检索负责过滤与分面,官网示例用统一的搜索对象把它们组合成一次查询并同时返回文档与分数。架构上它把索引建立在对象存储之上:查询层用内存与 SSD 缓存热温数据,全部向量、元数据与索引存放在 S3 或 GCS,官方用内存与对象存储的价格差解释「最高便宜 10 倍」,代价是冷查询要走对象存储、延迟明显更高。 官网公开的性能口径为:384 维、10 万向量时热查询 p50 20 毫秒、p99 57 毫秒,冷查询 p50 650 毫秒、p99 1.5 秒;单集合写入 30 MB/s、并发读 10 路,每库最多 100 万个集合、单集合最多 500 万条记录,召回率 90%–100%。此外还提供 Forking 能力用于数据集版本管理、A/B 测试与灰度放量,并把 Sync 作为官方数据摄取服务——直接连接 S3、代码仓库与网站,自动解析、切块与嵌入,起价每 GiB 处理量 0.04 美元。产品线中另有自研的开放权重检索模型 Context-1,官方称其在检索任务上可与前沿模型竞争且更快更便宜,目前通过等候名单开放。 云服务按用量计费,分为 Starter、Team 与 Enterprise 三档,官方声明通过 SOC 2 Type II,企业档提供 BYOC(数据面留在自己的 VPC)、多云多区域复制与时间点恢复。需要注意两点:开源包的最新发布记录为 1.5.9(2026 年 5 月 5 日),而仓库仍在持续提交,正式发版节奏与提交节奏并不一致,生产环境应以发布版本为准;官方基准数字来自其自有测试条件,迁移到自己的数据分布与查询热度时应重新实测。
核验信息
本页事实来自 Chroma 官方渠道:官网首页(定位、四类检索能力、对象存储与分层架构、成本对比、热/冷查询延迟与规格表、Forking、企业能力、星标与下载量口径)、Sync 产品页(数据源、解析切块嵌入流程、起价)、Agent 产品页(Context-1 的定位与速度成本口径)、价格页(三档方案与用量单价)与官方文档(快速开始、集合配置、全文检索、元数据过滤、条件事务、嵌入函数与命令行)。版本、单价与产品线状态核验于 2026 年 9 月 22 日,请以官方当期说明为准。
Chroma介绍页面对您是否有帮助?